Делаю ИИ-ассистентов, автоматизацию и интеграции для бизнеса и довожу их до продакшна. Умею запускать модели на сервере клиента, чтобы данные оставались внутри.
в коммерческой разработке: банки, финтех, производство
ПромсвязьбанкiFellowEPAMAlioth
Кейсы с ИИ
Цифры из замеров и рабочих проектов
Автоматизация рекрутинга
15 → 5 мин
Разбор одной анкеты кандидата в среднем. Поиск по базе резюме по смыслу, а не по словам: «кто работал с highload на C#».
в 3 разабыстрее разбор анкеты
с 11.2025проект в работе
RAGLLM.NET 8Локальные модели
Подробнее
Задача. Анкеты разбирали вручную, поиск по базе работал только по ключевым словам.
Решение. Семантический поиск по резюме и внутренним документам (нарезка, векторизация, переранжирование). Конвейер превращает свободный текст анкеты в проверенный JSON с навыками и опытом. Квантованные модели развёрнуты на серверах заказчика.
Ускорил движок для ИИ
+20%
к скорости обработки запроса. Правку приняли в открытый проект ik_llama.cpp.
274 → 329токенов/с, обработка запроса
9правок принято авторами
Подробнее
Сборка под Windows молча отключала быстрые инструкции процессора AVX-512. Замер на Ryzen 9 7950X и модели Qwen3-30B: обработка запроса 274 → 329 токенов/с, 10 повторов. Скорость генерации ответа не изменилась: она упирается в память, а не в процессор.
инструментов для ИИ-агентов. Выжимки из переписки и ответы на вопросы по ней.
5LLM-провайдеров, есть локальные
91файл тестов
Подробнее
Сервис хранит историю чатов, LLM делает выжимку за период и отвечает на вопросы с продолжением диалога. Агенты (Claude Code, Cursor) подключаются по MCP. Есть многопользовательский доступ и автодеплой на сервер. Покажу на созвоне.
Расшифровка встреч
5 форматов
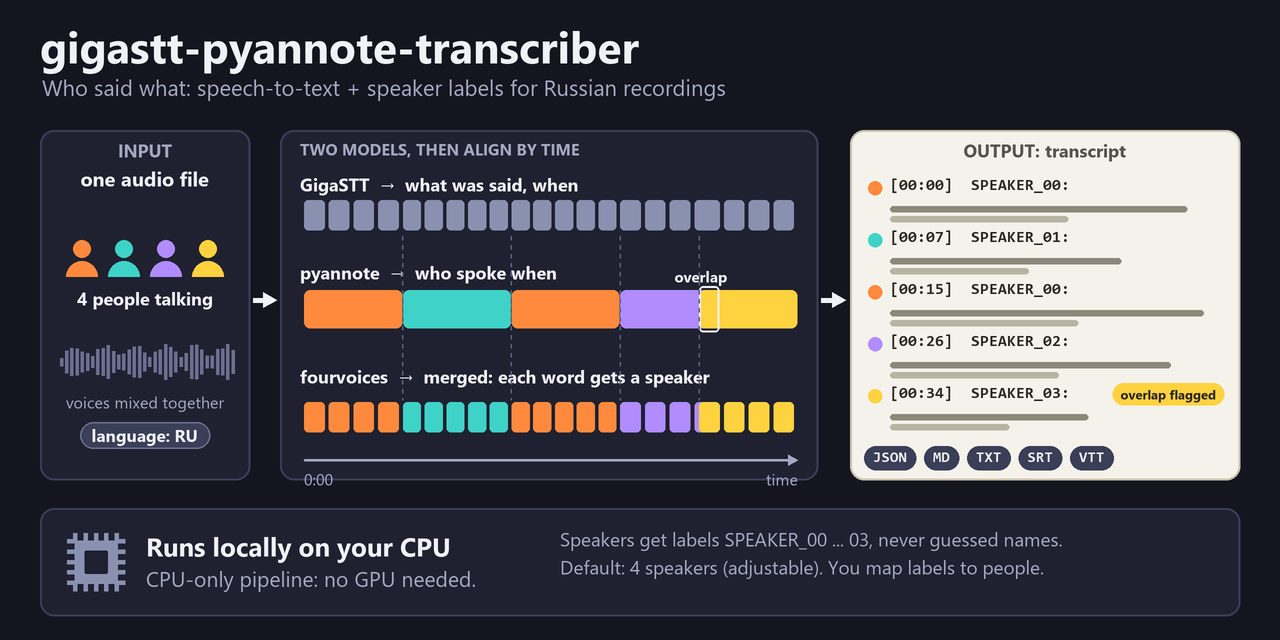
Запись созвона в текст «кто что сказал» с таймкодами. Без облака и видеокарты.
~230 МБпамяти на час записи
4собеседника: настройки по умолчанию
Подробнее
Одна модель распознаёт русскую речь (GigaAM), вторая разделяет голоса, каждое слово привязывается к говорящему. После установки запись не покидает компьютер. На выходе Markdown, текст, субтитры SRT и VTT, JSON.
Схема из репозитория: распознавание речи и разделение голосов сводятся по времени · нажмите, чтобы увеличить
Большие модели на ПК
≈230 млрд
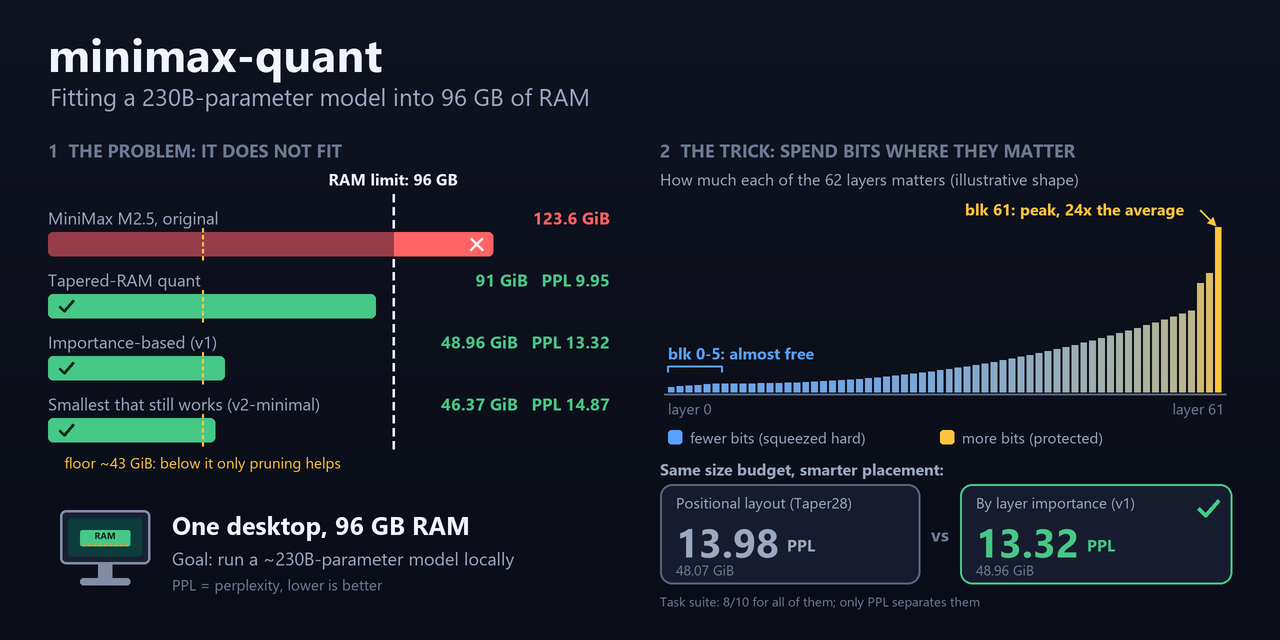
параметров в MiniMax M2.5. Запустил её на ПК с 96 ГБ памяти, без серверных видеокарт.
6,9токенов/с на процессоре, M2.5
457 ГБисходные веса M2.7 (BF16)
51 / 80 / 87 ГБпосле сжатия: в 5–9 раз меньше
Подробнее
Исследование, как уместить модели MiniMax M2.5 и M2.7 в память одного компьютера. 6,9 токенов/с — медиана 9 замеров для M2.5. Для M2.7 исходные веса BF16 (457 ГБ, 10 файлов) сжаты в три варианта, качество каждого проверено одним тестом. Рекомендованный вариант весит 80 ГБ и оставляет около 13 ГБ свободной памяти.
Схема из репозитория (M2.5): почему модель не помещается и как распределяются биты по слоям · нажмите, чтобы увеличить
Инструменты для агентов
340
автотестов в базе знаний для ИИ-агентов. Плюс общая память и скиллы для Claude Code.
14MCP-инструментов
10ИИ-клиентов подключаются к памяти
Подробнее
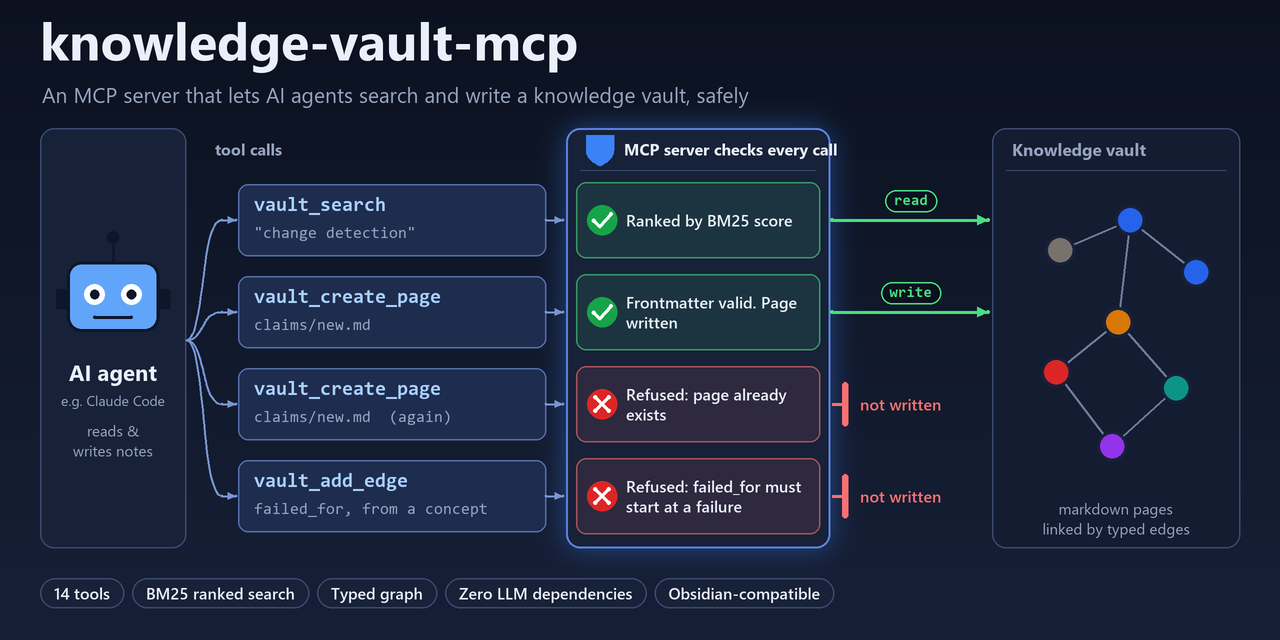
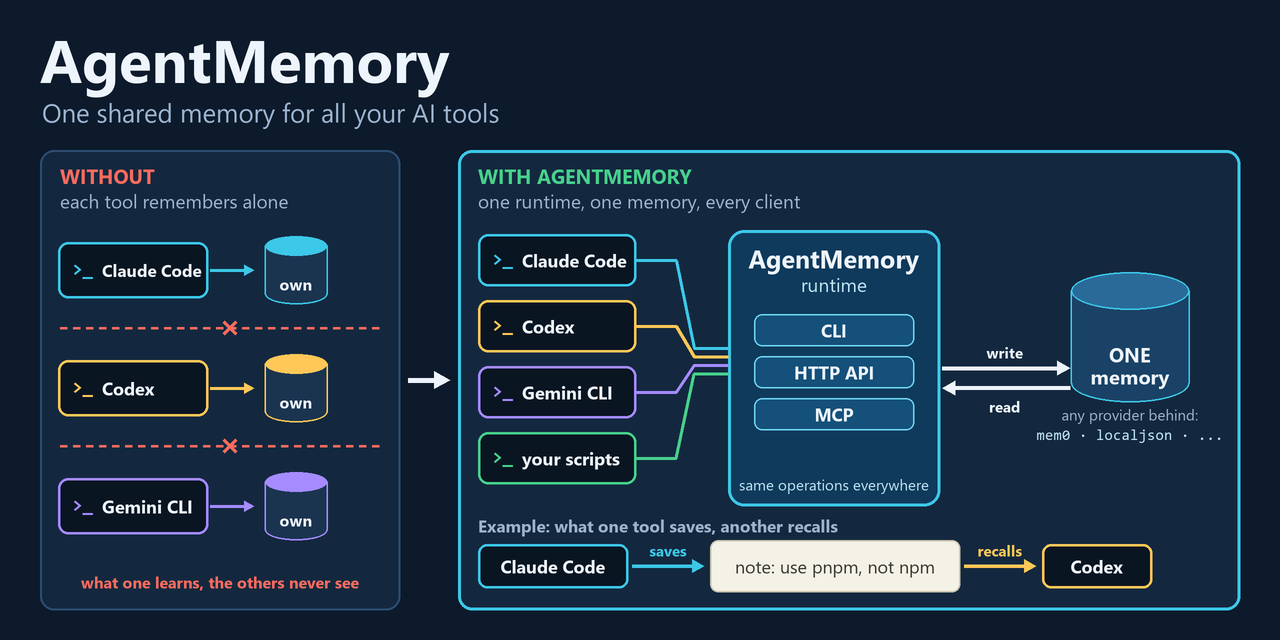
knowledge-vault-mcp: база знаний с поиском и проверкой дублей, 14 инструментов и 10 скиллов. AgentMemory: общая память, подключается к десяти ИИ-клиентам одной командой. belay: 6 скиллов, которые не дают агенту сдать непроверенную работу.
knowledge-vault-mcp: сервер проверяет каждый вызов агента · нажмите, чтобы увеличитьAgentMemory: одна память для всех ИИ-инструментов · нажмите, чтобы увеличить
Чем усилю команду
ИИ-ассистенты
Поиск по документам, разбор заявок, Telegram-боты
Скиллы для агентов
MCP-серверы, память, правила для Claude Code и Codex
Локальные модели
Запуск LLM на сервере клиента, данные не уходят наружу
Бэкенд и интеграции
.NET, SQL, API. Довожу до стабильной работы
Быстро, но с проверкой
ИИ пишет код быстро и ошибается уверенно, поэтому каждый шаг проверяемый.
СпецификацияЗадача по частям, у каждой критерий приёмки